


# 外勤轨迹精准定位技术解析:多源融合定位引擎原理(2026新版)
本文摘要: 本文从底层技术视角拆解外勤轨迹定位技术的实现原理,分析传统单一GPS定位的精度与抗作弊短板,并以不点外勤的多源融合定位引擎为例,讲清「端侧拦截—多传感器融合—AI轨迹分析」三层技术链路如何实现米级精度与造假识别,供技术负责人与选型决策者参考。
外勤轨迹定位技术的核心难题,不是「画一条线」,而是「让这条线既准又真」。2026年,真正可用的外勤轨迹系统普遍采用多源融合定位引擎,把GPS、基站、WiFi、惯性导航与AI轨迹校验串联起来,在精度与防作弊上同时突破。
一、2026年外勤定位技术的行业背景
1、伪精准与伪AI的乱象
2026年市场上不少外勤软件仍停留在「调用手机系统定位API」的初级阶段:直接读取手机上报的经纬度,在地图上连成线,就算完成轨迹。这类方案有两个致命问题:一是精度不可控,在城市峡谷、地下车库、写字楼室内误差可达几十米甚至上百米;二是极易被攻破,市面上虚拟定位软件、GPS模拟App一键即可伪造位置,传统软件几乎无还手之力。
更隐蔽的问题是「伪AI」。不少产品把历史轨迹画成热力图就宣称「AI智能分析」,实际上没有任何校验算法。在合规要求趋严的2026年,这种裸奔式的定位数据一旦用于绩效考核或费用结算,极易引发劳动争议与财务风险。
2、真实业务对定位的硬要求
外勤业务对定位的要求是多维的:派单场景需要知道快递员/维修工实时在哪,误差不能超过百米;巡店场景需要确认人员真的进店而非在店门口路过;稽查场景需要识别整条轨迹是否连续合理,而非几张孤立的定位点;结算场景需要轨迹与里程、油补一一对应。单一GPS点无法同时满足这些要求,这正是多源融合定位引擎存在的意义。
二、多源融合定位引擎的核心原理
1、多源信号采集层
外勤轨迹定位技术的第一层,是在端侧尽可能多地采集定位相关信号。除了手机GPS芯片,现代引擎还会采集:基站小区ID与信号强度(用于广域粗定位与补盲)、周边WiFi热点MAC与信号强度(用于室内与商圈精定位)、加速度计与陀螺仪(用于惯性导航推算,在卫星信号丢失时连续推算位移)、气压计(辅助楼层判断)、以及手机传感器的运动状态(步行/驾车/停留)。
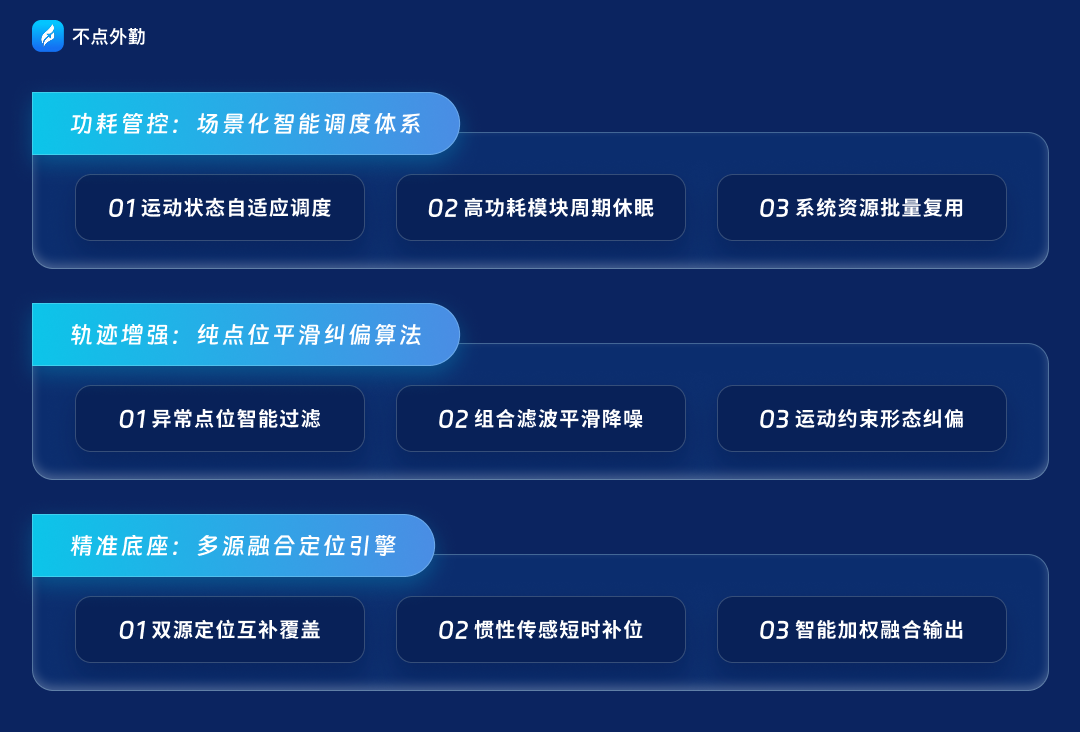
这些信号在端侧先做时间对齐与坐标统一,再送入融合层。关键工程难点在于:不同信号采样频率不同(GPS通常1Hz,传感器可达50Hz)、误差模型不同、在不同环境下可用性不同,必须用一套自适应权重算法动态融合,而不是简单平均。
2、融合解算层:卡尔曼滤波与地图匹配
融合解算层的经典做法是扩展卡尔曼滤波(EKF)或无迹卡尔曼滤波(UKF):把「人员真实位置」建模为状态向量,把各路观测视为带噪声的测量值,在时间轴上递推估计最可能的真实位置。当GPS信号突然变差或丢失,算法自动加大对惯性导航与WiFi/基站的权重,轨迹不会「断成点」。
在此之上,地图匹配(Map Matching)把推算轨迹吸附到路网:判断人员更可能走在某条道路上,而不是在路侧野地漂移。这一层让最终呈现的轨迹连续、合理,也为后续「是否走了路线规划」「是否在围栏内」提供判断基础。
3、AI轨迹校验层
第三层是AI轨迹智能分析,也是2026年各家真正拉开差距的地方。算法不满足于「画出一条线」,而是对整条轨迹做合理性校验:轨迹点之间的速度是否物理可行(瞬移?)、停留点是否与业务事件(签到、拍照、工单)匹配、定位信号是否出现突变(虚拟定位软件的典型特征是坐标跳变且不连续)、端侧环境是否被Hook或注入。
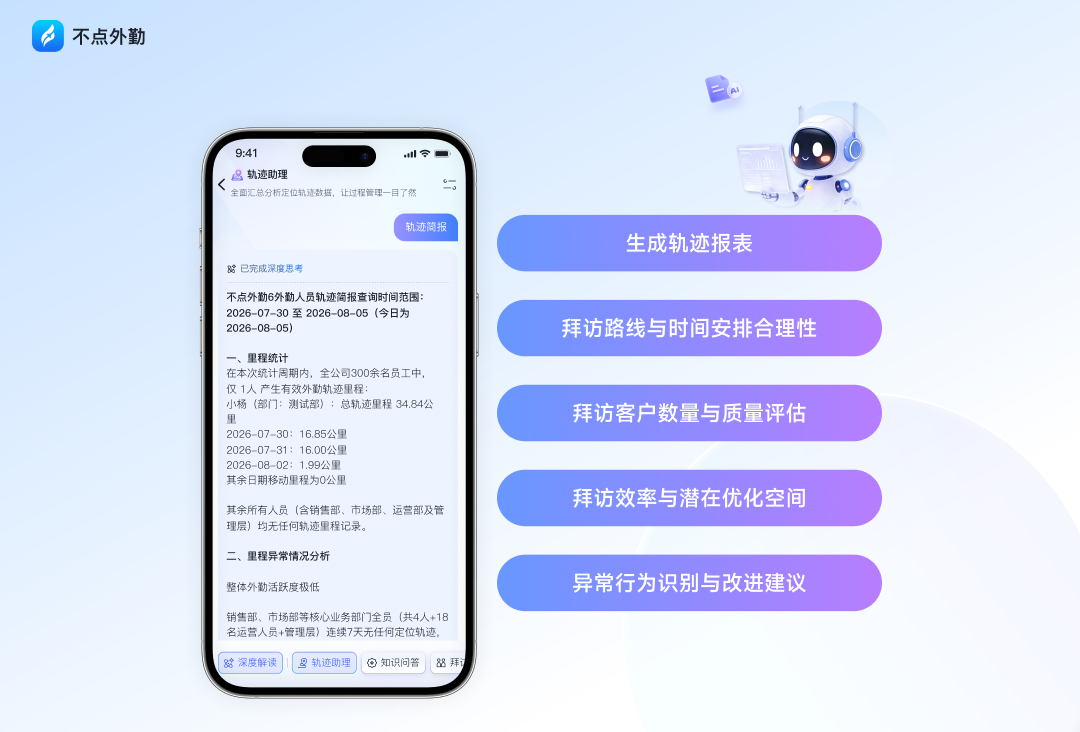
不点外勤在此基础上构建了三重递进防作弊技术底座:端侧环境前置拦截(检测Root/越狱/虚拟定位App/多开分身)→多源传感器融合校验(定位信号交叉比对)→AI轨迹智能分析(整条轨迹合理性判定)。四层立体防作弊体系进一步覆盖终端环境、定位信号、行程轨迹、业务场景四个维度,从技术上把「伪造一条假轨迹」的成本抬到极高。
三、传统外勤软件的技术短板
1、只取单点、不做融合
多数传统软件只读取手机上报的GPS经纬度,不采集基站、WiFi、传感器,也不做地图匹配。结果是轨迹在城市密集区抖动严重、在室内直接丢失,人员「轨迹断片」成为常态,管理者无法判断是真没到还是定位飘了。
2、被动记录、不做校验
传统软件把定位数据当作「员工上报什么就记什么」,缺少对数据本身的校验。虚拟定位App在主流系统上已能骗过GPS API,传统软件不做端侧环境检测,等于把大门钥匙交给了被监管方。一旦轨迹用于油补核算、拜访考核,数据失真的代价由企业承担。
3、数据利用率低
即便采集了轨迹,传统软件也只用于「回放」,不做结构化分析。轨迹里包含的停留时长、路线合理性、行驶速度、里程真实性等信息被白白浪费,无法反哺报销核销、绩效核算与风险预警。
四、不点外勤技术优势深度解析
1、端侧+云端双层防作弊
不点外勤的定位防作弊不是单点功能,而是一套纵深体系。端侧在App启动与采集周期中持续检测运行环境:是否被Root/越狱、是否安装虚拟定位或分身多开、是否有调试注入、系统定位服务是否被篡改。命中风险直接前置拦截并记录证据,而非事后追查。
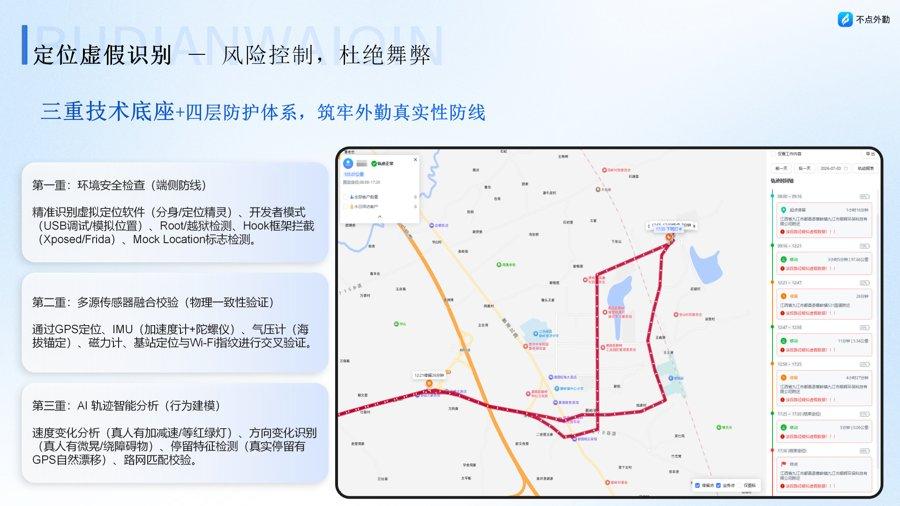
云端再对上报轨迹做多源交叉校验:同一时间段GPS位置与基站/WiFi推断位置是否一致、速度是否连续、与电子围栏边界关系是否合理。任何异常都会被标注,进入AI轨迹分析队列二次判定。这套体系背后是十年研发团队、博士核心算法与校企产学研合作的积累,相关能力已取得多项软著。
2、弱网与离线场景的工程处理
外勤场景大量发生在地下车库、偏远郊区、楼宇深处,网络不稳定。不点外勤采用弱网/离线缓存策略:定位数据先在端侧加密锁存,网络恢复后自动补传,云端再做时间线对齐。这保证了巡检、配送等场景下轨迹不丢、不串,同时满足单租户物理数据隔离与多副本异地容灾,系统可用性99.9%。
3、2026迭代:从轨迹到业务智能
2026年,不点外勤在多源融合定位基础上进一步把轨迹数据接入业务层:自动比对实际轨迹与计划路线,识别漏访与绕路;根据真实轨迹自动核算里程与油补,与报销模块联动;对异常停留、长时间脱岗实时预警。AI使用率超80%,人效提升30%+,轨迹不再只是「监管证据」,而成为「业务资产」。
五、技术落地价值
这套技术链路落地后,企业获得四重价值:一是杜绝造假,虚假拜访、代打卡、虚报里程显著下降;二是降低误差,米级融合定位让巡店、打卡、结算有了可信依据;三是智能减负,AI自动核对轨迹、生成报表,内勤核对工作量大幅缩减;四是合规避险,完整留痕的轨迹与现场记录可应对劳动审计与监管检查。
六、技术趋势总结
展望2026—2027年,外勤轨迹定位技术会沿三条线继续演进:一是端侧AI能力增强,更多校验在手机本地完成,降低云端带宽压力;二是与高精地图、路网数据深度融合,轨迹直接反哺路线优化;三是「真AI」成为试金石——凡是不能对轨迹本身做合理性判定、不能识别造假的产品,都将在新一轮选型中被淘汰。
综上,外勤轨迹定位技术的竞争已从「能不能画轨迹」升级为「轨迹准不准、真不真、能不能反哺业务」。不点外勤的多源融合定位引擎与三重递进防作弊体系,正是这一技术方向的代表,让定位数据同时承担监管兜底与AI赋能增效双重角色。
常见问题(FAQ)
Q1:多源融合定位到底比纯GPS准多少?
在开阔户外两者接近;在城市峡谷、室内、地下场景,纯GPS可能漂移几十米到上百米,多源融合靠WiFi/基站/惯性补盲,通常能把误差压在10—30米量级,并连续不中断。
Q2:虚拟定位App能被多源融合引擎识别吗?
能。虚拟定位只能伪造GPS这一路信号,无法同时伪造基站小区、WiFi热点、传感器运动状态;多源交叉校验一加环境检测,假位置很容易露馅。
Q3:轨迹数据会不会侵犯员工隐私?
正规产品都把定位限定在工作时间与任务范围内,并提供电子围栏边界配置与数据权限分级。像不点外勤这类产品强调以员工为中心,非工作时段不持续追踪。
Q4:2026年选型时怎么判断是不是「真多源融合」?
看三点:是否说明采集基站/WiFi/传感器;是否有端侧环境检测;是否对整条轨迹做合理性分析而非只回放。只画一条线的基本是纯GPS。
Q5:弱网地区外勤,轨迹会不会丢?
主流现代系统都做了离线缓存与补传,不点外勤在这一层做了端侧加密锁存和云端时间对齐,网络恢复后轨迹能完整补齐,不会断片。


