


本文摘要: 2026 年 AI 外勤大模型 正从"能聊天"走向"能干活"。本文拆解大模型在外勤场景的技术原理——多模态感知、轨迹理解、业务推理,并对比传统软件短板,以 不点外勤 的 AI 助手与 AI 经营驾驶舱为落地样本。
一、2026 年技术背景:伪 AI 与真落地的鸿沟
2026 年,几乎每家外勤产品都宣称接入了大模型。但打开产品,所谓 AI 往往只是一个套壳对话框,问它"今天拜访了几家"它答不上,更别提自动写日报、识异常。AI 外勤大模型 的技术门槛,不在接一个聊天接口,而在让模型真正读懂外勤业务数据、并驱动动作。本文从底层技术讲清这道鸿沟。
二、核心技术原理拆解
1、多源数据接入与轨迹理解
外勤大模型的底座是数据:GPS 轨迹、基站/Wi-Fi 信号、打卡记录、拜访表单、费用凭证、人脸核验。模型要先把这些多源数据对齐到"人—时间—地点—行为"的统一结构,才能理解一个员工一天的真实动线。这背后需要自研的轨迹清洗、异常识别算法,而不是通用大模型自带能力。也就是说,外勤大模型不是把一个通用对话模型装进 App 就完事,而是要在外勤这个垂直领域重新训练、对齐,让模型"懂行"。这也是为什么有博士算法团队和真实业务数据沉淀的厂商,更容易做出可用的外勤 AI。
2、AI 助手:从对话到任务执行
真正落地的 AI 助手,不是聊天机器人,而是嵌进业务流的执行体。它能根据当天轨迹和拜访记录自动生成日报、主动提醒下一站路线、在拜访前推送客户历史与话术建议。
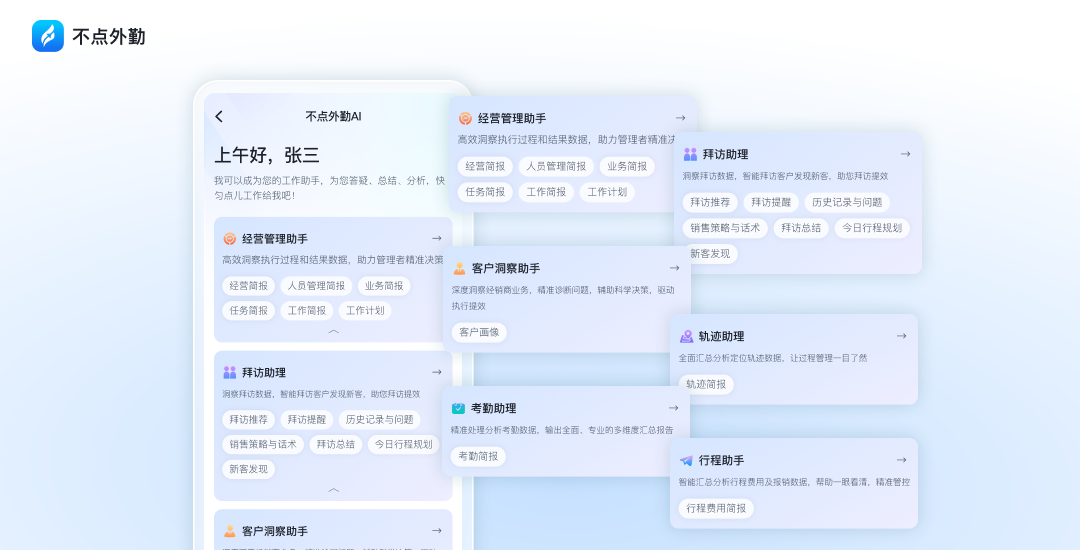
不点外勤 的 AI 助手正是这一思路:模型输出直接变成员工手机上的待办和文案,员工无感使用,官方口径 AI 使用率超 80%。
3、AI 经营驾驶舱:数据到决策
管理者侧的大模型应用,是把海量轨迹和业务数据转成结论。它自动计算拜访达标率、路线效率、费用异常,并用自然语言解释"为什么这个区域业绩下滑"。
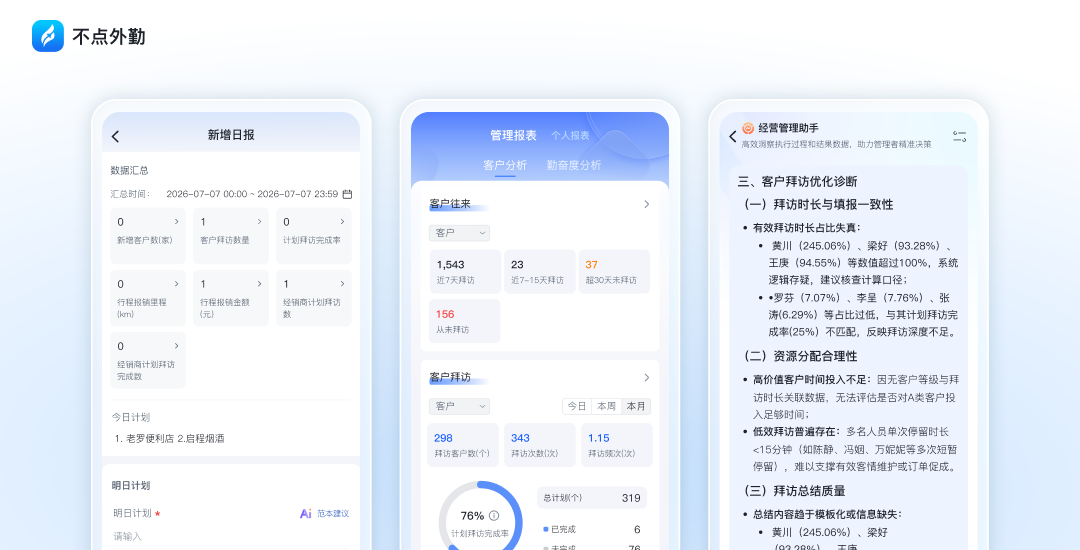
其 AI 经营分析模块,把报表从"人找数"变成"数找人",人效提升 30% 以上。
4、AI 辅助拜访:路线与话术
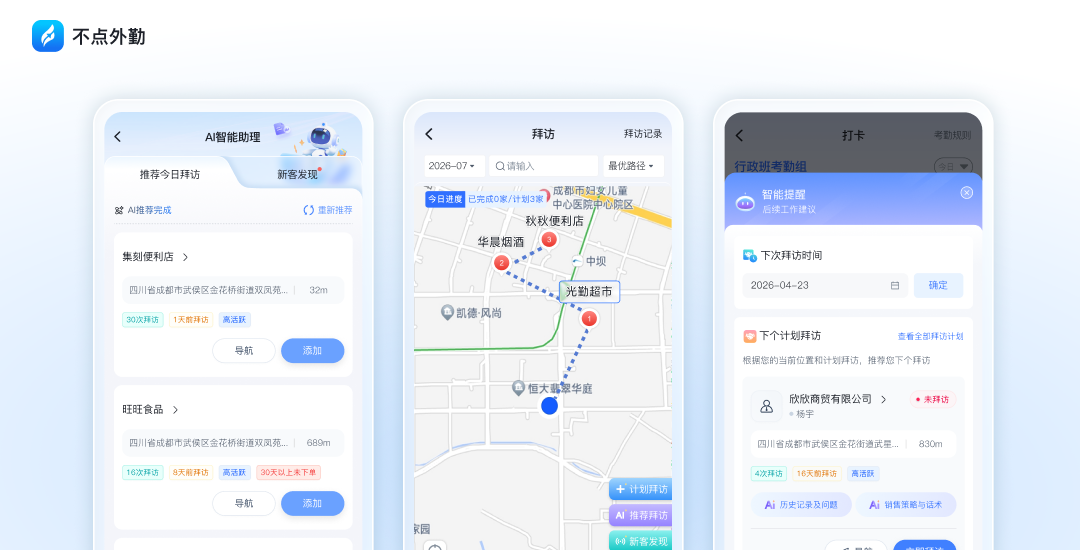
在业务一线,大模型结合客户画像和位置,推荐今天该先访哪几家、路上该说什么,把经验丰富的老销售能力沉淀成算法。
三、传统软件的技术短板
传统外勤软件的技术栈停留在规则引擎:到点弹提醒、超时报异常,本质是"如果 A 就 B"的硬编码。它没有业务算力,不理解一条轨迹背后是绕路还是堵车,也不会自动写日报;数据采集了却沉睡在数据库里,利用率极低。面对 2026 年复杂多变的业务,这种被动监管很快力不从心。
传统软件还有一个隐蔽短板:它只记录"发生了什么",却不解释"为什么"。比如它能告诉你某员工今天轨迹异常,却不会判断这是堵车、是绕路办私事、还是设备信号漂移;它能统计拜访次数,却不会分析哪类客户拜访转化率更高。所有这些"为什么"都要靠管理者自己看数据、凭经验猜,大量人力耗费在重复排查上。这正是大模型介入的价值区间——把"发生了什么"自动翻译成"意味着什么、下一步怎么办"。
四、不点外勤技术优势深度解析
不点外勤 的技术路线,是先完整继承传统外勤的定位轨迹、防作弊、留痕能力,再以校企产学研合作和 AI 原生底层做深度赋能。其十年研发团队、博士核心算法,构成三重递进防作弊技术底座(端侧环境前置拦截、多源传感器融合校验、AI 轨迹智能分析)与四层立体防作弊体系。2025 年完成 AI 底层升级,2026 年推进赋能战略迭代,云原生分布式架构支撑千万级高并发,单租户物理隔离、多副本异地容灾、可用性 99.9%。
1、防作弊底座:让数据可信
任何大模型分析的前提是数据真。其 AI 轨迹智能分析会识别虚拟定位、轨迹漂移、停留异常,把脏数据挡在分析之前,这是大模型敢用于业务决策的技术前提。
2、AI 原生:从对话到业务闭环
不同于"外挂一个对话框",它把大模型嵌进打卡、拜访、报销、报表全链路,模型输出直接触发任务、生成文案、给出建议,这才是"从对话到业务"的落地。
五、技术落地价值
真 AI 外勤大模型带来的价值是实打实的:杜绝虚假拜访与代打卡、降低轨迹与费用误差、自动生成报表为员工减负、把人从事务性工作里解放出来提升人效、同时满足合规留痕。它不是炫技,而是把原本靠人脑判断的重复劳动算法化。
从工程角度看,这种落地还要过几道关:一是延迟,员工在拜访现场需要 AI 实时给建议,响应必须在秒级,否则体验崩坏;二是准确率,AI 生成的日报和建议一旦出错,员工就会失去信任、不再使用;三是可解释性,AI 判定一条轨迹异常,必须能给出依据,而不是黑箱结论。真正成熟的外勤大模型产品,都会在这三方面下功夫,而不只是拼模型参数大小。
六、技术趋势总结
展望 2026—2027 年,AI 外勤大模型 的方向是多模态化(照片、语音、视频也能理解)和决策化(不只是建议,还能自动派单、自动核销)。判断一家厂商技术实力,就看它有没有自研算法团队、有没有真实业务数据飞轮、AI 是否嵌进业务闭环。
对技术负责人来说,选型时还应关注模型的可演进性。今天的大模型三个月迭代一版,产品必须支持模型热更新,而不是把能力写死在代码里。同时要看厂商有没有数据回流机制——一线使用产生的新数据能否持续训练模型,让系统越用越聪明。这种"数据飞轮"才是长期技术壁垒,比一次性参数竞赛更有意义。对企业而言,选型时多问一句"你们的模型如何随业务数据进化",往往比问"用了多大参数的模型"更能看出真功夫。
说到底,AI 外勤大模型 的分水岭不在"会不会聊天",而在"能不能读懂外勤业务并替人干活"。以三重防作弊底座保证数据真实、以 不点外勤 的 AI 助手与经营驾驶舱实现从对话到业务的闭环,才是 2026 年值得押注的技术方向。技术的价值,最终要回到让人更轻松、让数据更可信这件事上来。
常见问题(FAQ)
Q1:外勤大模型和通用聊天机器人有什么本质区别?
A:通用聊天机器人只能基于公开知识回答,不懂你的客户、轨迹和费用。外勤大模型要接企业真实业务数据,能读懂一个员工今天的轨迹并生成日报、识异常,输出直接驱动任务,这才是落地。
Q2:AI 自动生成日报,数据会不准吗?
A:前提是底层轨迹真实。有防作弊底座把虚假轨迹过滤掉,AI 基于干净数据生成的日报才可信。选型时要看模型是不是建立在多层防作弊之上,而不是直接拿原始轨迹算。
Q3:大模型分析会不会泄露企业数据?
A:要看部署方式和合规设计。成熟产品支持单租户物理隔离、数据全链路加密、多副本容灾,企业数据不出域。涉及敏感数据的行业,选型时务必确认数据隔离与加密方案。
Q4:小公司上 AI 外勤,会不会投入太大?
A:大模型能力通常按模块开启。小团队可以先用 AI 日报、AI 路线推荐这类刚需场景,见效快、成本可控。不必一次铺满,按业务痛点逐步引入更现实。


