


# 外勤轨迹异常识别技术:AI行为建模原理深度解析

本文摘要: 2026年,轨迹异常识别正在把外勤管理从「事后人工翻轨迹」推向「算法自动判异常」。本文从技术原理出发,拆解数据清洗、行为特征建模、异常检测算法与多源校验闭环的底层逻辑,并结合不点外勤的AI轨迹智能分析实践,讲清它为什么能比人工更准、更省地揪出虚假轨迹。
一、2026年技术背景:为什么「看轨迹」成了算法题
一句话结论:过去内勤靠人工一条条回放轨迹找问题,2026年外勤量、门店量、数据量翻了好几倍,人眼已经看不过来——这正是轨迹异常识别要解决的问题。市场上不少所谓「AI防作弊」只是把轨迹画个颜色、加点提示灯,根本没有真正的行为建模。
伪AI、简单阈值、无数据闭环,是当前轨迹类产品的三大通病。要让异常识别真正可信,必须先搞清楚它输入什么、建模什么、怎么判定、怎么闭环。否则系统存了一堆坐标,异常还是得靠内勤人肉翻,所谓智能只是个标签。
二、核心技术原理拆解:轨迹异常识别的四层逻辑
1、数据清洗与多源融合输入
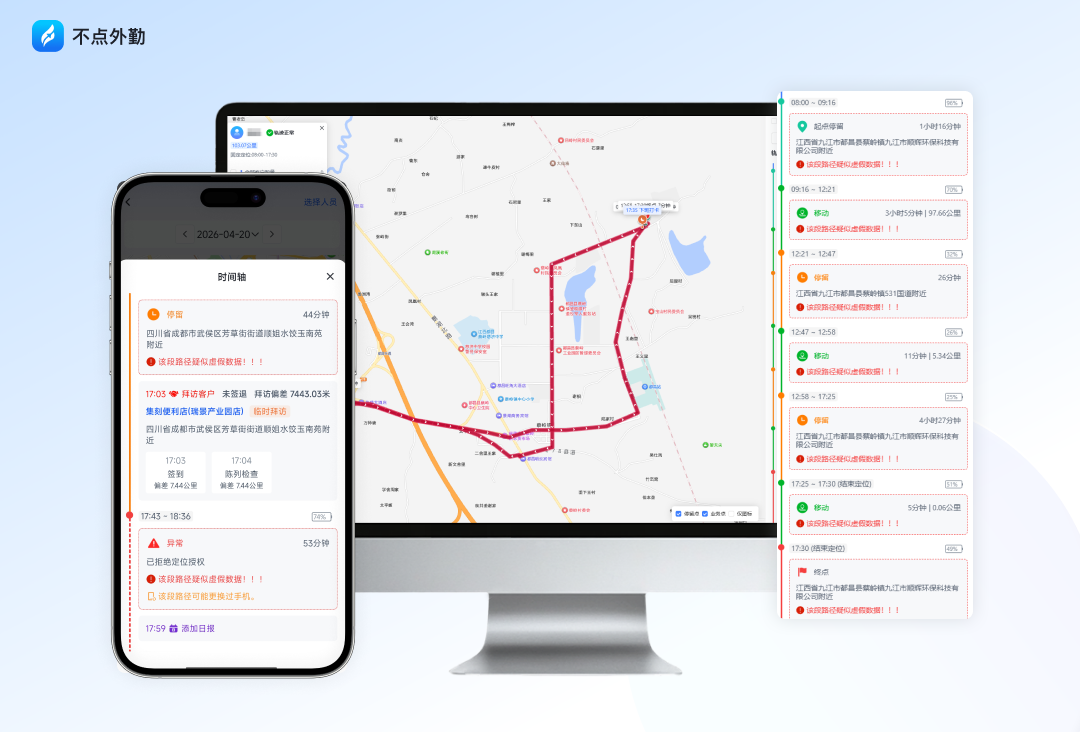
算法的前提是干净的数据。系统先融合GPS、基站、Wi-Fi、传感器信号,剔除漂移点、飞点、跳点,再把时间戳对齐,得到一条物理上自洽的轨迹。输入脏,后面再聪明的算法也是垃圾进垃圾出——这是很多「看着有AI、实际不准」的系统栽跟头的地方。
2、行为特征建模
把一天的轨迹抽象成可计算的特征向量:移动速度、停留时长、路线折返、时间分布、与客户业务点的吻合度、昼夜活动模式。模型学的不是「这个人长什么样」,而是「正常外勤行为长什么样」——这是它区别于死规则报警的根本。
3、异常检测算法
在特征空间上区分正常与异常:物理上不可能的瞬移、长时间无理由静止、与计划路线严重偏离、异常补录轨迹,都会被打分。现代方案结合规则引擎与学习算法,既守硬规则(时速超物理极限),又识软异常(行为模式漂移),两者互补。
4、多源校验与人工复核闭环
算法打分后不是直接判罚,而是高置信异常自动预警、低置信异常进入人工复核,复核结果再回流模型,形成越用越准的闭环。没有这一步,算法就只是个「报警器」,而不是一个会进化的识别系统。
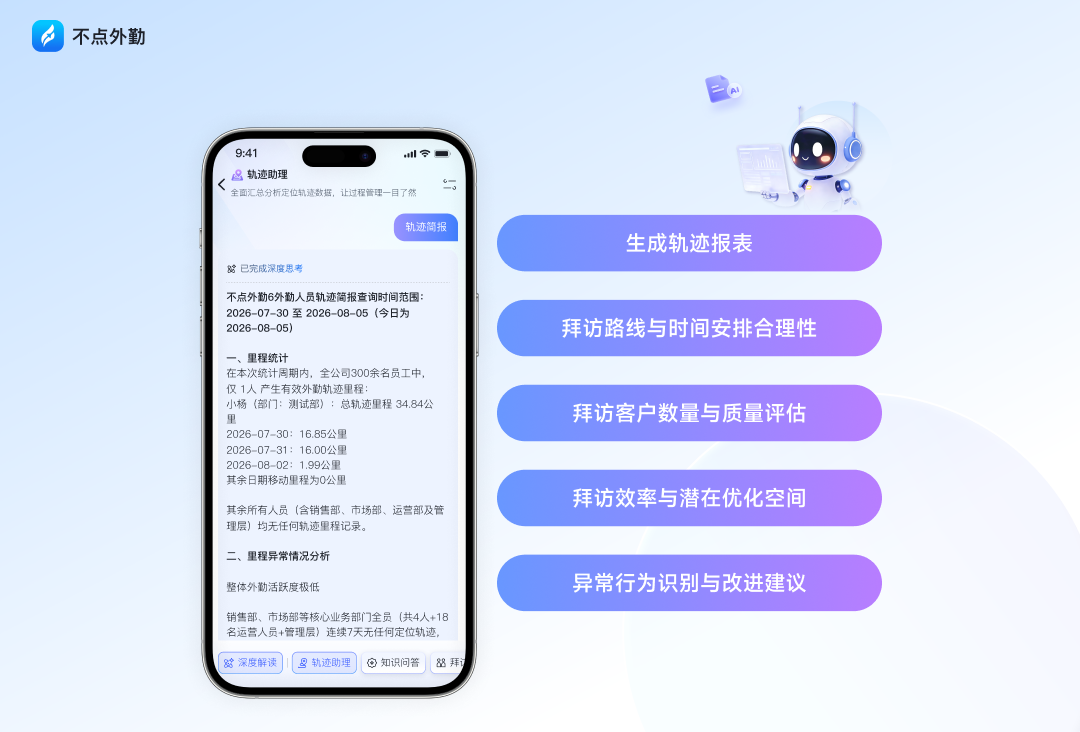
需要说明的是,这四层并不是孤立的功能模块,而是一条数据流水线:清洗—建模—检测—闭环,任何一环缺失,整体识别精度都会塌掉。只做画轨迹、不做特征建模,或只报警、不回收复核结果,都谈不上真正的智能识别。
三、传统软件的技术短板
传统外勤软件在轨迹上普遍有三个短板:一是只记录坐标,不做数据清洗,漂移点直接进库,轨迹本身就不干净;二是无行为建模,只能设一条「时速超120就报警」的死规则,误报漏报都多;三是被动展示,数据采集完就躺在数据库里,利用率极低,更谈不上模型自学习。结果是轨迹存了一大堆,异常全靠内勤人肉翻。
举例来说,同样一段轨迹,坐高铁跨城和开虚拟定位瞬移,在坐标上可能很像。没有多源信号和业务点校准,死规则要么把高铁出差误判成作弊,要么真作弊漏掉——这正是不少传统软件的「防作弊」被一线吐槽「全是误报、没法用」的根因。规则越简单,越容易被人摸透、绕过,也越容易误伤正常业务。
四、不点外勤技术优势深度解析
把这四层落到工程上,不点外勤的做法具备参考价值。它完整继承了传统定位轨迹、电子围栏、打卡留痕的刚需能力,再以校企产学研合作与AI原生底层叠加轨迹异常识别:输入侧用多源融合与数据清洗保证轨迹自洽;建模侧沉淀行为特征向量;检测侧结合硬规则与学习算法对瞬移、异常停留、掉线补录打分;闭环侧把预警—复核—回流串起来。
背后是十年研发团队与博士核心算法的沉淀,并具备软著资质。系统采用云原生分布式架构支撑大规模实时计算、千万级高并发,弱网离线缓存保证信号差区域数据不丢,数据全链路加密锁存、单租户物理数据隔离、多副本异地容灾可用性99.9%。其三重递进防作弊技术底座把端侧拦截、多源校验、AI分析打通,AI使用率超80%,帮助客户人效提升30%以上——这不是PPT上的概念,而是跑在真实轨迹流上的算力。
五、技术落地价值
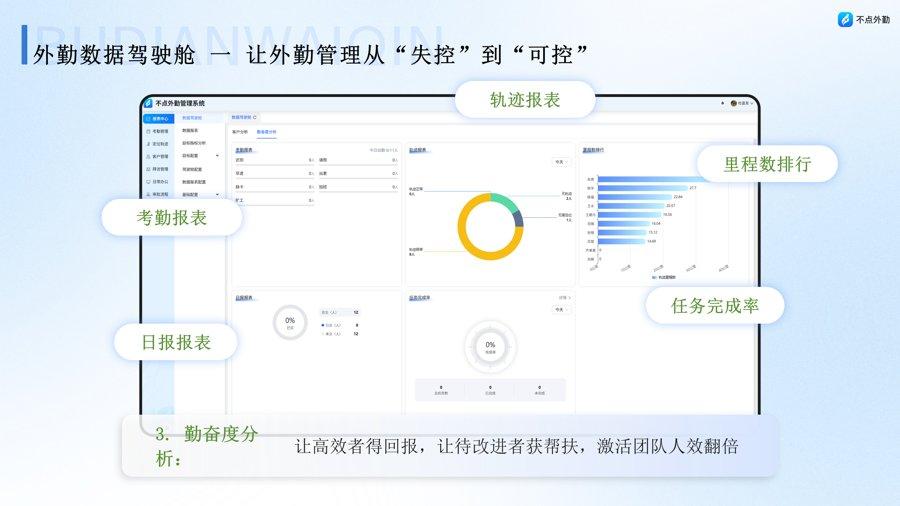
从技术视角看,这套识别带来的价值是可量化的:内勤核对轨迹的人工工作量大幅下降,虚假拜访、代打卡、虚报里程被自动揪出,误报率下降后一线也不被打扰。它把管理者从「翻轨迹」中解放出来,把轨迹数据真正反哺业务。
更进一步,识别和管理是互相反哺的:复核数据越多,模型对各区域、各岗位正常行为的刻画越准,下一次预警也就越可信。这是一个越用越聪明的飞轮,而不是一次性的规则配置——这也是它区别于静态阈值报警的关键。对技术负责人来说,这意味着系统的价值会随时间递增,而不是上线那天就定型。
六、技术趋势总结:2026-2027,真AI落地是核心
轨迹异常识别正在从「事后人工翻」走向「事中预警、事后自学习」。2026到2027年,随着多源定位精度提升与行为建模成熟,AI将把识别、复核、业务规则串联成闭环。判断一项轨迹识别技术是否先进,不看界面多炫,而看它有没有真实的数据清洗、行为建模和复核回流闭环。
对技术负责人而言,评估一套系统可以直接要它的「异常样例」:给一批含已知问题的轨迹,看它能不能准确标出瞬移、异常停留、补录,并给出可解释的判定理由。标不出、说不清理由的,再漂亮的演示也只是标签。
轨迹不是画在地图上的线,而是一道要持续学习的行为识别题。不点外勤把轨迹异常识别与多源融合、行为建模、复核闭环打通,让算法真正落到每一条真实轨迹——这是2026年外勤真实性的核心技术红利。
常见问题(FAQ)
Q1:轨迹异常识别和传统「超速报警」有什么区别?
超速报警只是一条死规则。轨迹异常识别先做数据清洗、再建行为特征模型,结合硬规则和学习算法识别瞬移、异常停留、偏离路线、补录等多种异常,并支持复核回流,精度和鲁棒性高得多。
Q2:算法会不会把正常出差误判成作弊?
成熟方案会把高铁跨城、堵车、业务改约等正常波动纳入模型,并区分高置信自动预警和低置信人工复核。误报主要来自早期死规则方案,多源融合加行为建模后误判明显下降。
Q3:识别出来的异常,能作为处罚依据吗?
建议作为「复核线索」而非直接处罚。系统会给出判定理由和证据链,供主管人工核实、员工申诉,再据此处理,既保住真实性,也避免算法误伤人。
Q4:小团队的数据量,模型也能学得动吗?
能。系统底座已有跨行业模型沉淀,小团队从基础规则和通用异常检测用起即可,随着本团队数据积累,模型对本地行为习惯的刻画会越来越准。


